Community Data License Agreement – Permissive: una licenza opendata ben studiata

Da un post del blog del progetto open source Who’s On First vengo solo oggi a conoscenza del progetto CDLA - Community Data License Agreement della Linux Foundation nato nell’ottobre 2017.

CDLA si pone come un progetto di licenze collaborative per consentire l’accesso, la condivisione e l’uso dei dati aperti tra individui e organizzazioni.
Creative Commons vs Open Data Commons
Detto cosi suona come un qualcosa di già rivisto nei progetti come Creative Commons o come Open Data Commons, in realtà il progetto si pone nell’offrire una soluzione molto più pragmatica e vicina all’uso reale dei dati. Le Open Data Commons nascevano per superare il limite del diritto sui generis (= il diritto sulle banche dati) non presente nelle Creative Commons ed hanno avuto la loro fortuna con l’adozione, da parte del progetto OpenStreetMap, della licenza ODbL. La ODbL si è dimostrata una licenza interessante nel mondo del copyleft in quanto introduce un concetto non ancora applicato ai dati: un dataset rilasciato in ODbL può essere usato a qualsiasi scopo, con l’obbligo però di restituire tutte le modifiche con gli stessi termini della licenza e di citare la fonte nei prodotti derivati. Detto nel caso specifico di OpenStreetMap: le modifiche ai dati devono essere sempre accessibili a chiunque e mai chiuse, mentre, la creazione di mappe può usare un qualsiasi tipo di licenza, a patto che citi la fonte con la dicitura “© OpenStreetMap contributors”.
Una che offre un buon compromesso fra l’obbligo di tenere sempre la banca dati ap erta e il suo riuso.
Nel frattempo le licenze Creative Commons, usate sempre più spesso anche per i dati, dalla versione 4.0 hanno inserito i riferimenti al diritto sui generis ed hanno accontentato i molti che chiedevano a gran voce di poter usare la licenze CC-BY (quella con il solo vincolo di attribuzione) sui dati, divenendo, almeno per l’Italia, la licenza open data più utilizzata.
Di contro le evoluzioni delle Creative Commons non sono andate di pari passo con la ODbL (che di fatto è rimasta lì ferma) arrivando addirittura a creare una incompatibilità fra le due creando così un balzo indietro per cui, ora, è necessario chiedere il permesso per importare i dati …
CDLA: licenze pragmatiche per il riuso dei dati
Le premesse di CDLA nascono invece da un discorso prettamente pragmatico della necessità di riusare i dati, e, il fatto che sia Linux Foundation a farsene carico è molto emblematico. CDLA infatti si presenta dicendo comunità di software open source hanno dimostrato il potere della collaborazione aperta creando le risorse software più importanti del mondo. Esistono anche comunità che cercano di costruire in modo collaborativo banche dati che possono essere condivise e sviluppate in un modello molto simile a quello software. Ad esempio, il machine learning (l’apprendimento automatico) e i sistemi di intelligenza artificiale che necessitano di una grande quantità di dati di addestramento. I governi inoltre stanno cercando soluzioni per stabilire la condivisione dei dati fra pubblico e privato.
Il progetto mette subito in evidenza la necessità di avere licenze sui dati in grado di replicare quello che sono le licenze sul software chiari del fatto che la proprietà intellettuale in questi casi è molto diversa a causa proprio dell’oggetto che si sta trattando (= sviluppo di software contro la creazione/distribuzione di dati).
Community Data License Agreement pertanto propone due soluzioni per ricalcare quelli che sono i vincoli delle due macro-categorie di licenze sul software: le licenze permissive (es. apache) e quelle copyleft (es. gpl) creando rispettivamente la CDLA-Permissive e la CDLA-Sharing
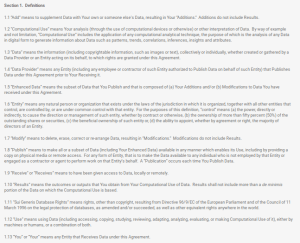
le definizioni presenti nel testi delle licenze CDLA
 Le licenze solitamente cominciano nel creare la definizione dei termini necessari per specificare chi rilascia i dati, chi va a riusarli e tutti i casi del come riusare.
Ecco, nei vari “come” troviamo parole come “Add”, “Computational Use”, “Enhanced Data”, “Modify”, “Publish”,”Receive”, “Results” … tutte “azioni” che fa chiunque si ritrova a maneggiare dati (in particolare i data scientist) nelle continue trasformazioni, integrazioni e distribuzioni nel proprio lavoro.
Assieme a questi vale la pena citare anche altre due definizioni: quella “data” (= dati) dove si specifica “le informazioni (comprese le informazioni sul copyright, come immagini o testo), collettive o individuali, create o raccolte da un fornitore di dati o da un’entità che agisce per suo conto […]” e quella di “diritto sui generis sulle banche dati” con il preciso riferimento alla direttiva europea che la ha introdotto.
Queste necessità di introdurre queste definizioni fa capire, da subito, che la licenza è ben studiata e incentrata sul reale riuso dei dati evitando di creare inutili discussioni e problemi giuridici complessi.
Il caso della CDLA Permissive
WOF - Who’s On First è un progetto che fornisce un gazetteer di luoghi geografici interrogabile via API. Il progetto nasce da una idea della startup Mapzen e si proponeva dall’inizio sul rilascio dei dati in CC0 per poi valutare il rilascio in CC-BY a causa della continua integrazione fra fonti dati diverse. Con la chiusura di Mapzen, WOF ha trovato proprio in Linux Foundation lo sponsor per proseguire l’attività e, da qui, hanno ricevuto la proposta di valutare il passaggio dalla CC-BY alla CDLA Permissive. Le considerazioni che il team di WOF fa sono riportate nel blog post “Proposed change to the Who’s On First data license” e si basano principalmente sulle FAQ del progetto CDLA. La lettura mi convince in maniera immediata per il suo pragmantismo nel bilanciare le questioni di attribuzione con quelle di riuso proprio in ambito di dati. Ecco una sintesi delle considerazioni in merito:
- CDLA è una licenza basata sul vincolo di attribuzione che soddisfa gli obblighi verso le nostre fonti dati.
- CDLA copre le banche dati come un record intero e individuale, mentre CC-BY non è ottimizzata per dati o database.
- CDLA copre in maniera inequivocabile i diritti per utilizzare e pubblicare i dati in modo permissivo.
- CDLA stabilisce che i "dati avanzati" (data enhanced) non sono considerati una paternità comune. Ciò vuole chiaramente dire che il mixaggio dei dati con dati che fanno uso di altre licenze è garantito, ed incoraggia una più ampia circolazione dei dati distribuiti con questa licenza evitando la discussione sulle banche date collettive o derivate.
- CDLA distingue in maniera esplicita fra dati forniti con la licenza CDLA, ed i "risultati" ottenuti elaborando o analizzando tali dati senza imporre obblighi o restrizioni ai risultati. Questo stabilisce senza ombra di dubbi che l'uso di Who's On First (o simili) nelle applicazioni di geocoding non inquina i risultati della geocodifica.
Dataset rilasciati con questa licenza, che offre questi termini di riuso permettono il riuso a chiunque (anche grandi istituzioni ed imprese) eliminando moltissime incertezze.
Conclusioni
Il blog post di Who’s On First conclude dicendo “è vero che ora facciamo parte della Linux Foundation e che questa licenza è quella predefinita da loro per il rilascio dei dataset, ma è anche vero che non siamo obbligati a cambiare licenze, anche se, questi termini ci convincono moltissimo che questa sia la via da seguire”.
E personalmente anche io, dopo tutti questi anni di discussioni fra lo scegliere una licenza creative commons (cc-by) o una italiana (la iodl 2.0) o la continua discussione sulla validità giuridica della cc0, credo proprio che questo caso sia quello di gran lunga più interessante se non altro perché, finalmente, siamo davanti ad un testo di licenza sui dati pensata proprio per tutte le azioni di riuso sui dati. Io ci credo.